Восстание журналистов против сбора данных с помощью ИИ
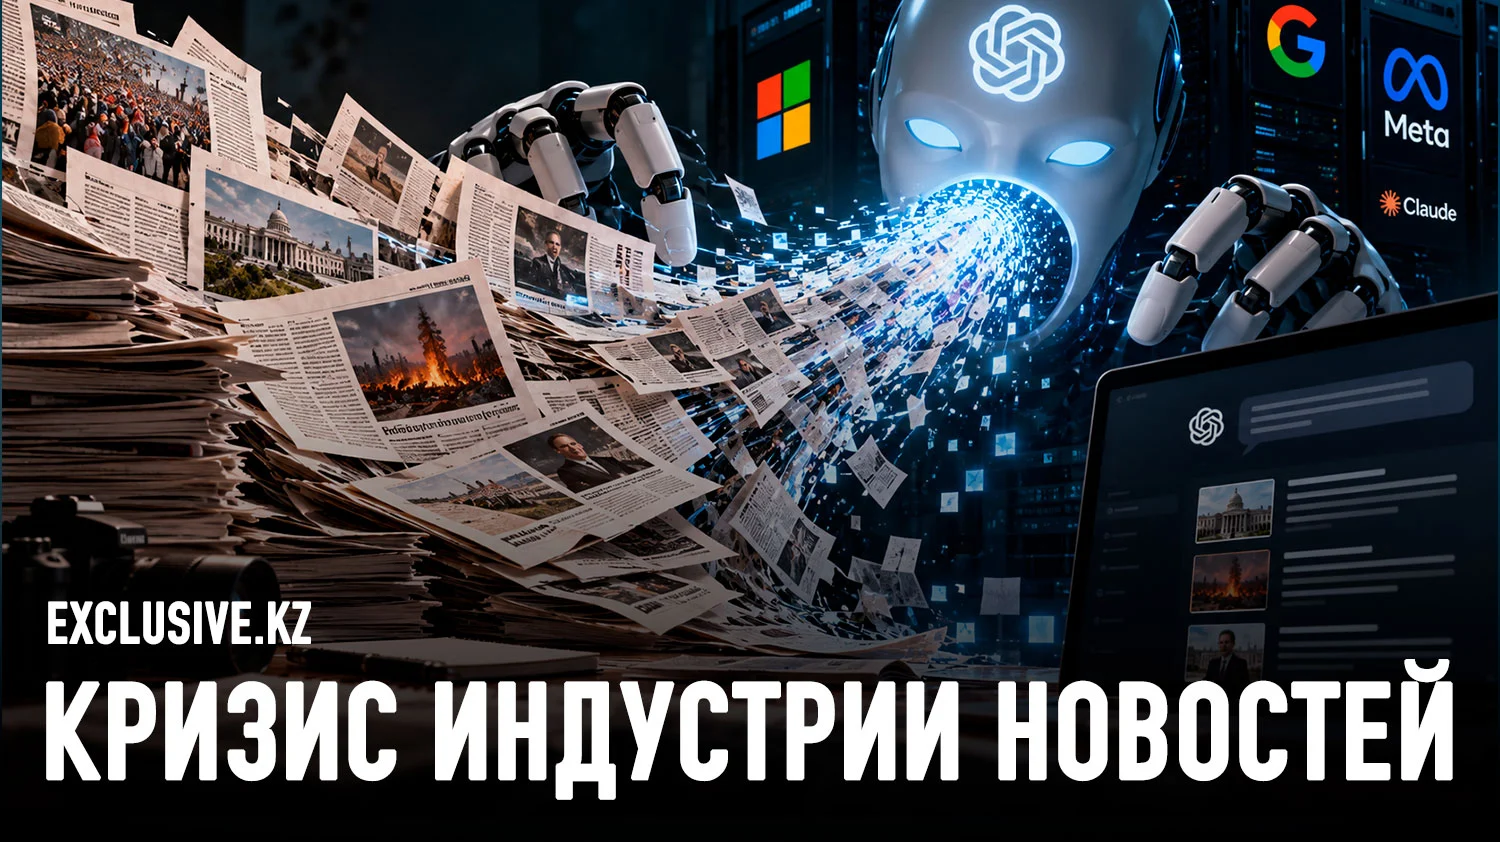
Всего за несколько лет такие инструменты искусственного интеллекта, как ChatGPT и Claude, стали массовой технологией. Компании, стоящие за этими инновационными продуктами, рекламируют их огромную потенциальную пользу для человечества. Однако эта риторика, хотя и не обязательно ошибочная, упускает из виду тот факт, что эти модели построены на массовом хищении произведений, защищенных авторским правом, и угрожают еще больше ослабить и без того хрупкую опору демократии – журналистику.
- Editorial Perfil подало иск против OpenAI и Microsoft в Федеральном гражданском и коммерческом суде Аргентины за неправомерное использование журналистского контента и недобросовестную конкуренцию.
- Иск поданне за контент на продуктах на базе искусственного интеллекта, включая чат-боты ChatGPT и Claude.
- NYT подала аналогичный иск против OpenAI и Microsoft в конце 2023 года; Folha de São Paulo возбудила похожее дело в 2025 году, приведшее к соглашению о лицензировании в начале 2026 года; OpenAI применяла подобные лицензии и к PRISA/El País.
- Утверждается, что ИИ-компании используют контент защищенный авторским правом и обходят платные барьеры, чтобы увеличить трафик и продажи рекламы/подписок.
- Anthropic урегулировала коллективный иск в Калифорнии, заплатив авторам книг 1,5 млрд долларов за обучение Claude пиратскими копиями их произведений.
- Редакция указывает на усиление доминирования технологических компаний, потерю трафика для издателей и угрозу финансированию журналистики из-за ИИ и монополий на рынке.
Именно поэтому Editorial Perfil – крупное латиноамериканское издательство со штаб-квартирой в Аргентине (а также владелец газеты «Perfil», в которой я занимаю должность директора по цифровым технологиям) – недавно подало иск против владельца ChatGPT, компании OpenAI, и крупнейшего внешнего акционера этой компании, Microsoft, за неправомерное использование журналистского контента Editorial Perfil в их продуктах на базе ИИ. В иске о возмещении ущерба, поданном в Федеральный гражданский и коммерческий суд Аргентины, мы также обвинили эти компании в «недобросовестной конкуренции» – иными словами, в злоупотреблении своим олигополистическим положением в ущерб нам.
Хотя Editorial Perfil является первым испаноязычным издателем, подавшим иск о нарушении авторских прав против компании, занимающейся искусственным интеллектом, оно следует по стопам The New York Times, которая в конце 2023 года подала иск против OpenAI и Microsoft по тому же вопросу. Бразильская газета Folha de São Paulo возбудила аналогичное дело в 2025 году, что в конечном итоге привело к заключению соглашения о лицензировании контента в начале этого года (такой подход OpenAI применяла и в отношении других издателей, включая испанский конгломерат PRISA, стоящий за газетой El País).
Мы уже сталкивались с подобным: доминирующие поисковые системы и социальные сети также извлекали выгоду из новостного контента, защищенного авторским правом, не всегда делясь при этом доходами. Поисковые системы – например, «бесплатная» модель Google – сделали новостные статьи гораздо более доступными, размещая их на страницах результатов поиска. Но, несмотря на то что Google в значительной степени полагался на этот защищенный авторским правом контент для увеличения доходов от рекламы, от компании не требовали выплачивать адекватную компенсацию медиакомпаниям, которые, возможно, нанимали сотни журналистов для его создания. Да, эти системы распространения привлекали трафик на сайты издателей, но условия конкуренции никогда не были равными и все больше склонялись в пользу технологических компаний по мере укрепления их власти.
В эпоху искусственного интеллекта OpenAI и Anthropic (владелец Claude), а также устоявшиеся технологические гиганты, такие как Google и Meta (владелец Instagram и Facebook), значительно усилили эту динамику. Чат-боты и другие корпоративные продукты на базе ИИ, созданные ими на основе все более сложных крупных языковых моделей, напрямую отвечают на вопросы интернет-пользователей, лишая новостные ресурсы трафика и возможности показывать рекламу или продавать подписки потенциальным читателям.
Этим моделям требовались огромные объемы обучающих данных, значительная часть которых представляла собой материалы, защищенные авторским правом, незаконно скопированные из интернета. Недавно компания Anthropic урегулировала коллективный иск в Калифорнии, согласившись выплатить 1,5 миллиарда долларов авторам книг, которые утверждали, что компания скачивала пиратские копии их произведений для обучения Claude. При этом модели постоянно жаждут новых данных, особенно актуальной информации о текущих событиях.
В Editorial Perfil мы выявили множество случаев, когда ChatGPT может в мельчайших деталях воспроизводить контент из нашего исторического архива. То же самое происходит с новостями в режиме реального времени, и система даже предлагает пользователям запрашивать ежедневный обзор новостей, чтобы они не тратили время на посещение множества сайтов. Он легко обходит платные барьеры; для статей, которые он не может найти на собственных сайтах Editorial Perfil, он использует поддельные сайты, незаконно перепечатывающие их. Исторические данные серверов показывают, что множество ботов постоянно сканирует наш контент – не только от OpenAI, но и от всех компаний, занимающихся искусственным интеллектом.
Эти вопиющие злоупотребления очевидны для любого человека, обладающего здравым смыслом. Компании, занимающиеся искусственным интеллектом, не только крадут контент, но и поощряют пользователей оставаться в пределах своих закрытых экосистем, превращая Интернет в олигополистический рынок. При этом они по-прежнему пытаются утверждать, что занимаются «добросовестным использованием» «общедоступного» контента. К сожалению для OpenAI, компания уже признала ценность журналистики, заключив множество лицензионных соглашений. В отличие от этого, Anthropic избегает заключения соглашений о лицензировании контента с новостными организациями.
Индустрия новостей переживает кризис с тех пор, как более двух десятилетий назад цифровая революция перевернула её бизнес-модель. Новая, более устойчивая модель так и не появилась. Хотя мы, представители СМИ, не сумели предвидеть, как развитие интернета изменит всё, мы пытались переосмыслить свою деятельность уже после того, как это произошло. Но олигополистическое доминирование «больших технологических компаний» не дало нам добиться реального прогресса, а ИИ только усугубляет кризис.
Разрушение новостной индустрии – плохой исход для всех. Это приведёт не только к снижению информированности общественности, но и нанесёт ущерб самим паразитирующим ИИ-компаниям, лишив их важного источника данных для обучения. Если они не хотят действовать в интересах общества, им следует хотя бы позаботиться о своих собственных интересах.
Авторские права: Project Syndicate, 2026. www.project-syndicate.org
Иллюстрация на обложке сгенерирована с помощью ИИ
Все комментарии проходят предварительную модерацию редакцией и появляются не сразу.